WPF TreeView の縦スクロールバーが表示されない問題を解決した話(WPF-UI)
GitBranchMetrics の Gitツリー画面を作っているときに、
TreeView の縦スクロールバーだけが表示されない
という現象に遭遇しました。
横スクロールバーは表示されるのに、縦だけ出ない。
しかも一瞬だけ表示されて、すぐ消える。
今回はその原因と解決方法のまとめです。
症状
- 横スクロールバー → 正常に表示される
- 縦スクロールバー → 一瞬出るがすぐ消える
- スクロール自体は可能
ScrollViewer.VerticalScrollBarVisibility="Auto"では表示されない
WPF-UI を使用している環境です。
原因
結論から言うと、TreeView に高さ制約が正しく与えられていなかった ことが原因でした。
TreeView 内部には ScrollViewer が含まれています。
しかし、
- 親レイアウトが
*(スターサイズ) - 高さ制限が実質無限扱い
- Viewport と Extent の差が発生しない
という状態になると、ScrollViewer は
「全部表示できるから縦スクロールバーは不要」
と判断してしまいます。
そのため、VerticalScrollBarVisibility="Auto" では表示されません。
解決方法
① TreeView を ScrollViewer でラップ
外側に ScrollViewer を配置しました。
<ScrollViewer VerticalScrollBarVisibility="Visible"
              HorizontalScrollBarVisibility="Auto">
    <TreeView
        ScrollViewer.VerticalScrollBarVisibility="Disabled"
        ScrollViewer.HorizontalScrollBarVisibility="Disabled"
        ... />
</ScrollViewer>
② 高さ制約を与える(MaxHeight)
コード側で MaxHeight を設定。
BranchTreeView.MaxHeight = someCalculatedHeight;
これにより、
- Viewport < Extent の状態が明確になり
- 縦スクロールバーが正しく表示される
ようになりました。
デバッグでの確認ポイント
Visual Studio の Live Visual Tree を使うと原因が分かりやすいです。
確認するプロパティ:
VerticalScrollBarVisibilityComputedVerticalScrollBarVisibilityViewportHeightExtentHeight
ComputedVerticalScrollBarVisibility が Collapsed になっている場合、
レイアウト的に「不要」と判断されている
ということになります。
最終対応
今回は安定性を優先し、
BranchTreeView.ScrollViewer.VerticalScrollBarVisibility
    = ScrollBarVisibility.Visible;
として 縦スクロールバーを常時表示 にしました。
現在は安定しています。
学び
WPF でスクロールバーが出ない場合、
スタイルの問題ではなく、レイアウト制約の問題
であることが多い。
特に TreeView / ListBox / DataGrid など
内部 ScrollViewer を持つコントロールでは注意が必要。
まとめ
- 横が出て縦が出ない場合はレイアウトを疑う
- MaxHeight / Height 制約が重要
- Live Visual Tree で
ComputedVerticalScrollBarVisibilityを確認 - 必要なら外側 ScrollViewer で制御
WPF はレイアウトが全て。
地味だけど、かなり勉強になったトラブルでした。
宣伝
この記事が良いなと思った方はこちらもお試しいただけると幸いです。
① Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。
あのFilesよりも高速です。
apps.microsoft.com

② Apple Musicなどで再生中の楽曲をXでシェアするアプリです。
apps.microsoft.com
こんな感じ。
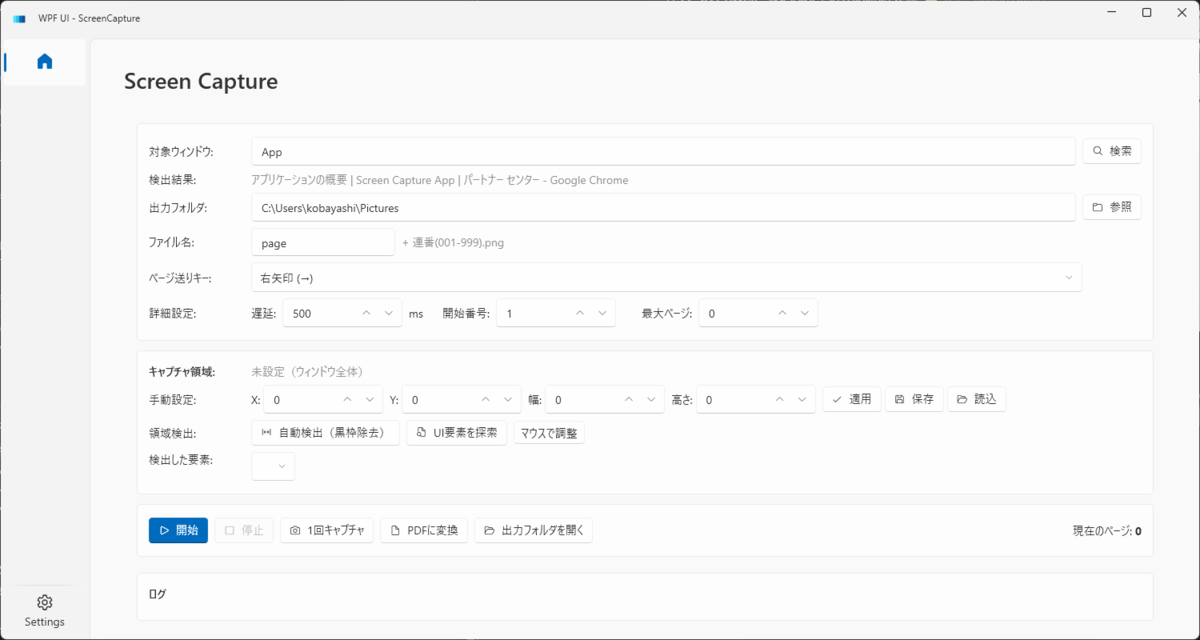
③ KindleなどのアプリをキャプチャーしてPDF化できます。
Screen Capture App
apps.microsoft.com
④ AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
⑤ GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com

Windows11で音声出力デバイスを変更しても反映されない問題の解決方法
発生した現象
Windows 11 で音声出力デバイスを変更したのに、
実際には変更前のデバイス(一覧の一番上のデバイス)から音が出続ける現象が発生しました。
既定のデバイスを変更しても反映されませんでした。
原因
多くのアプリは、
という実装になっています。
つまり内部的には次のような流れになります。
アプリ起動 → 出力デバイス確定 → 固定
そのため、Windows側で既定デバイスを変更しても、
アプリが再取得しない限り反映されません。
解決方法
1. Windowsで既定の出力デバイスを変更
設定 → システム → サウンド → 出力 から変更
2. アプリを完全終了する
3. 再度アプリを起動
これで正常に既定デバイスから音が出ました。
なぜ「一番上のデバイス」から音が出るのか?
一部アプリは
- 既定デバイス ではなく
- 最初に見つかったアクティブなオーディオエンドポイント
を使用することがあります。
特に以下のアプリで起きやすいです。
- Chrome
- Electron系アプリ
- 一部ゲーム
- 動画プレイヤー
今後ハマらないためのコツ
- 先に既定デバイスを変更
- その後アプリを起動
この順番にすることでトラブルを回避できます。
まとめ
Windows 11 で音声出力デバイスが切り替わらない場合は、
まずアプリを再起動してみるのが最も簡単で効果的な解決方法です。
意外と単純な原因ですが、知らないとハマりますね。
Cursor Pro+ の料金挙動を実測して分かったこと(Auto / gpt-5.2 の正体)
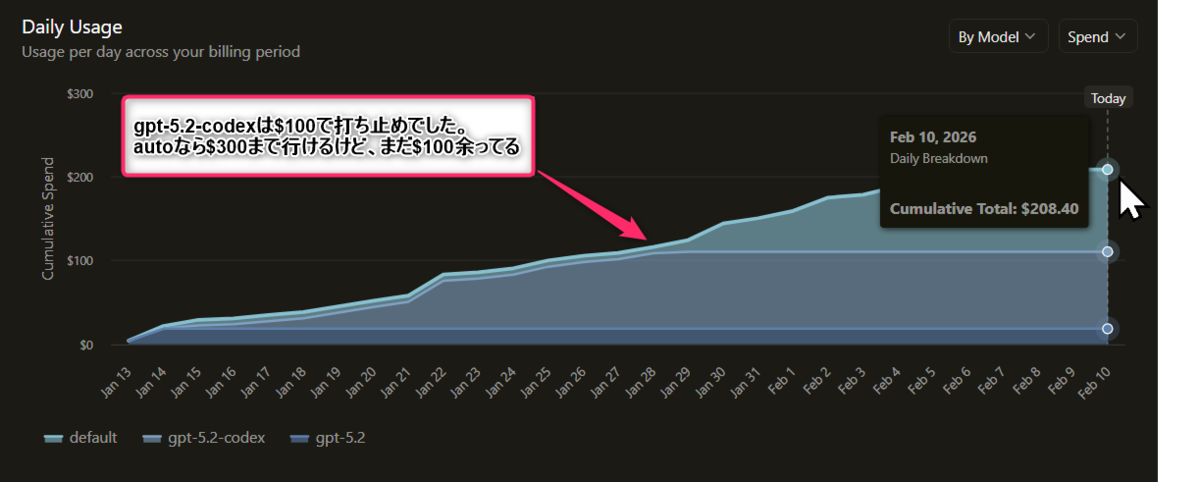
Cursor Pro+ を実際にガッツリ使ってみて、 「料金モデルって実際どうなってるの?」という疑問に対して、 グラフと打ち止め画面まで含めて検証できたのでまとめます。
結論から言うと、
gpt-5.2 を約 $100 使えて、Auto を併用すると約 $300 まで伸びる ただし、最終的なハード上限に当たると完全停止します。
使用環境
① gpt-5.2 固定で使った場合
- 利用額が 約 $100 前後で頭打ち
- それ以上は実質使えない(強い制限)
- ただし品質は非常に安定
所感 - 設計 - 難しいバグ - アーキテクチャ判断
こういう「思考コストが高い場面」専用という印象。
② Auto に切り替えた場合
- $100 を超えても そのまま使い続けられる
- 合計で 約 $300 前後まで伸びる
- 内部的には軽量モデル+必要に応じて強モデルを混在させている感じ
ポイント - Auto = 安物モデル固定、ではない - 「ここは重い」と判断されたところでは、それなりのモデルが使われていそう
③ そして最終的な打ち止め
しばらく使い続けると、ついにこの画面が出ます。
You've hit your usage limit
Upgrade for more usage. Get more credits on higher plans.
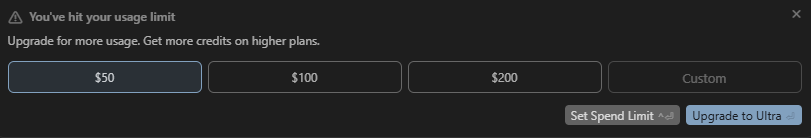
この表示が出た時点で:
- Auto にしても復活しない
- 軽いプロンプトでも無理
- モデルを下げても通らない
完全に打ち止めです。
つまり:
Auto は無限ではない
Pro+ 全体に「絶対に超えられない月次上限」がある
ということが確定しました。
実測から分かった構造まとめ
体感+実測ベースで整理すると、こうなります。
- gpt-5.2 固定枠:約 $100
- Auto 併用時の拡張枠:約 $300
- ただし Pro+ 全体の最終ハード上限あり
- 上限到達後は強制停止(追加課金 or 翌月待ち)
おすすめ運用(個人開発・業務向け)
月前半
- Auto メイン
- 実装・試行錯誤・雑多な修正を一気に進める
ここぞという時だけ
- gpt-5.2 固定
- 設計
- 判断が重いところ
- バグの核心
月後半($250 付近)
- プロンプトを短く
- Cursor 外(ChatGPT / Claude)併用
- 「考えさせる系」は温存
まとめ
Cursor Pro+ は実質的に
「gpt-5.2 を $100 、Auto を使って合計 $300 使えるプラン」
ただし、 最後は必ず打ち止めが来る。
この挙動を把握しておくと、 - 無駄撃ちが減る - 月内の設計判断をどこに集中させるか決めやすい
というメリットがあります。
同じように Cursor を使っている人の参考になれば幸いです。
宣伝
この記事が良いなと思った方はこちらもお試しいただけると幸いです。
KindleなどのアプリをキャプチャーしてPDF化できます。
Screen Capture App
apps.microsoft.com
AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com
Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。あのFilesよりも高速です。
apps.microsoft.com
.NET 6 / 7 / 8 / 9 / 10 世代比較表(WPF / Desktop 観点)
本ドキュメントは、WPF / Desktop アプリ開発者向けに
.NET 6 / 7 / 8 / 9 / 10 の世代差分を 実務影響・破壊的変更の観点で横並び比較したものです。
全体サマリ
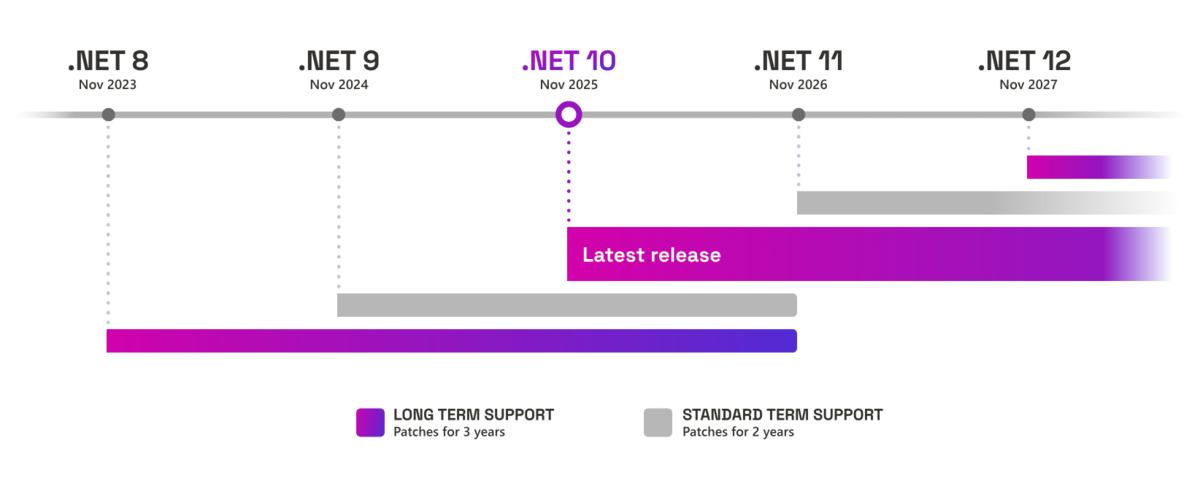
.NET 6(LTS)
- 2024年11月12日サポート終了
- 互換性が高いが、以降の世代で顕在化する改善(Dispatcher/入力/非同期)が少ないため、タイミング依存コードが温存されがち
- BinaryFormatter が非推奨
.NET 7
- 2024年5月14日サポート終了
- 破壊的変更は少なく、既存アプリはほぼそのまま動く
.NET 8(LTS)
- 2026年11月10日サポート終了予定
- パフォーマンス・スレッド・Dispatcher 改善
- 入力・非同期まわりで「挙動差」が出始める
.NET 9
- 2026年11月10日サポート終了予定
- セキュリティ起因の破壊が顕在化
- BinaryFormatter が完全に削除
.NET 10(LTS)
- 2028年11月14日サポート終了予定
- .NET 9 で壊れた領域の「正解ルート」を提示
- Typed API / 明示的設計への移行を強く促す世代
世代比較表
| 観点 | .NET 6 | .NET 7 | .NET 8 | .NET 9 | .NET 10 | 実務影響 |
|---|---|---|---|---|---|---|
| サポート終了 | 2024/11/12 | 2024/5/14 | 2026/11/10 | 2026/11/10 | 2028/11/14 | |
| LTS | ❌ | ❌ | 🔼 | ❌ | ✅ | 長期運用は 6 / 8 / 10 |
| WPF 安定度 | 高 | 高 | 高 | 中 | 高 | 9 は注意 |
| 破壊的変更量 | 少 | 少 | 少 | 多 | 中 | 9 が最大 |
| Dispatcher / UI スレッド | 従来挙動 | 従来〜小改善 | 最適化 | 同左 | さらに最適化 | タイミング依存バグ |
| Key / 入力ルーティング | 従来 | 従来 | 厳密化 | 同左 | 同左 | DataGrid / TextBox |
| BinaryFormatter | 使用可能(非推奨) | 使用可能(非推奨) | 使用可能(警告増) | 削除 | 削除(復活なし) | 🔴 |
| Clipboard(カスタム型) | DataObject 前提 | 同左 | 同左 | 不安定 | Typed API | 🔴 |
| Clipboard.GetData(object) | 使用可 | 使用可 | 使用可 | 使用可 | obsolete 傾向 | 🟠 |
| Typed Clipboard API | ❌ | ❌ | ❌ | ❌ | ✅ | 設計変更 |
| Drag & Drop | 安定 | 安定 | 安定 | 壊れやすい | 安定(型付き) | 🟠 |
| 非同期 / Task | 従来 | 従来 | 改善 | 改善 | 即時キャンセル強化 | finally 依存注意 |
| GC / メモリ | 従来 | 従来 | 改善 | 改善 | 改善 | タイミング差 |
| 移行難易度 | — | 低 | 低 | 高 | 中 | 9→10 は設計変更 |
| 推奨用途 | 既存安定運用 | 既存維持 | 安定運用 | 検証用 | 本命 | — |
世代ごとの「踏みやすい地雷」
.NET 6
- 長年動いているコードほど「タイミング依存」が温存されがち(Dispatcher、入力、非同期初期化)
- 後続世代で最適化されると、偶然動いていた順序がズレて顕在化することがある
.NET 7
- 特になし(安定)
- 技術的負債が表に出にくい
.NET 8
- Dispatcher 優先度依存コード
- PreviewKeyDown / KeyDown の順序依存
- 非同期初期化のタイミング
.NET 9
.NET 10
移行戦略のおすすめ
| 現在 | 推奨ルート | |
|---|---|---|
| .NET 6 | → 10(EOL to LTS) | 途中の .NET 8 はスキップする |
| .NET 7 | → 10(EOL to LTS) | 途中の .NET 8 はスキップする |
| .NET 8 | → 10(LTS to LTS) | |
| .NET 9 | → 10(設計見直し必須) | |
| 新規 | .NET 10 一択 |
検証ソリューション(BC01〜BC03)との対応(目安)
| プロジェクト | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|
| BC01 Legacy Clipboard | ○ | ○ | ○ | △ | △(obsolete) |
| BC02 Typed Clipboard | × | × | × | × | ◎ |
| BC03 Unsafe BinaryFormatter | ○ | ○ | ○ | × | △(検証のみ) |
BC01〜BC03はこちらにあります。 github.com
結論
- .NET 6 / 7 / 8:安定・既存資産向け(6/7 は EOL)
- .NET 9:破壊を認識するための世代
- .NET 10:将来を見据えた「完成形」
WPF / Desktop アプリは
👉 .NET 10 + 型付き API + 明示設計 が長期的に最も安全です。
.NET 10はパフォーマンス改善もあるのでおすすめ。
※ 本資料は WPF / Desktop 観点にスコープを限定しています。
各バージョン毎の破壊的変更はこちらのページに詳細が載っていますので、一読していただければと。
learn.microsoft.com
宣伝
この記事が良いなと思った方はこちらもお試しいただけると幸いです。
KindleなどのアプリをキャプチャーしてPDF化できます。
Screen Capture App
apps.microsoft.com
AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com
Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。あのFilesよりも高速です。
apps.microsoft.com
SQL Server Express の 10GB 制限をどう回避するか
― 水平分割(年別DB)を中心にした実運用ガイド ―
SQL Server Express は 1 データベースあたり 10GB という明確な制限があります。
小〜中規模アプリでは魅力的な無料版ですが、運用を続けると必ずこの壁に当たります。
本記事では、
- 水平分割と垂直分割の違い
- なぜ「水平分割(年別DB)」が運用向きなのか
- 年別DBを VIEW で隠蔽する実践パターン
- 年替わり時に事故らない運用手順
を、実務目線で整理します。
SQL Server Express の制限
- 制限対象:データベース単位
- 制限サイズ:10GB / DB
- テーブル数やDB数は制限なし
👉 つまり「DBを分ければ容量は増やせる」という設計余地があります。
分割戦略は2種類ある
① 水平分割(行で分ける)
- 同じテーブル構造のまま、行を期間などで分割
- 代表例:年別DB、月別DB
App_2026.dbo.Documents
App_2025.dbo.Documents
② 垂直分割(列で分ける)
- 1行のデータを 用途別に列単位で分離
- 代表例:本文・添付・ログを別テーブル/別DBへ
Documents        (軽い列)
DocumentBody     (本文)
DocumentFiles    (添付)
水平分割 vs 垂直分割(運用目線)
| 観点 | 水平分割 | 垂直分割 |
|---|---|---|
| 10GB回避 | ◎ | ◎ |
| 導入の簡単さ | ◎ | △ |
| 運用の楽さ | ◎ | △〜× |
| 当年データ性能 | ◎ | ○ |
| 横断検索 | △(工夫が必要) | ○ |
| バックアップ/復元 | ◎ | △ |
| 事故りにくさ | ◎ | △ |
結論:
Express回避の第一手は「水平分割(年別DB)」が最も安全。
なぜ水平分割(年別DB)が強いのか
- データ増加が 時間軸に沿って自然に分離 できる
- 現役DB(当年)だけを重点運用できる
- 過去DBは READ_ONLY にできる
- 障害・復元・バックアップの切り分けが簡単
👉 「運用で壊れにくい」のが最大の強み。
問題:年別DBをアプリにどう隠すか?
アプリが毎年
FROM App_2026.dbo.Documents
のように変わるのは地獄です。
解決策:GatewayDB + VIEW
- アプリは GatewayDB にだけ接続
- 実体DBは VIEW の裏側に隠す
App
 ↓
GatewayDB (VIEW)
 ↓
App_2026 / App_2025
パターン1:当年だけを指す VIEW(基本)
CREATE VIEW dbo.Documents AS
SELECT * FROM App_2026.dbo.Documents;
年が変わったら:
ALTER VIEW dbo.Documents AS
SELECT * FROM App_2027.dbo.Documents;
✅ アプリ無変更
✅ 差し替えは VIEW だけ
パターン2:全期間横断 VIEW(検索・レポ用)
CREATE VIEW dbo.Documents_All AS
SELECT *, 2026 AS DataYear FROM App_2026.dbo.Documents
UNION ALL
SELECT *, 2025 AS DataYear FROM App_2025.dbo.Documents;
UNIONではなくUNION ALLを使うDataYear列で期間絞り込み可能
実運用でおすすめの構成
dbo.Documents→ 当年のみ(通常CRUD)dbo.Documents_All→ 横断検索・レポ専用
👉 日常クエリを重くしないのが重要。
書き込みはどうする?
おすすめ:ストアドプロシージャに寄せる
- 読み取り:VIEW
- 書き込み:
GatewayDB.dbo.Documents_Insertなど
年が変わっても SPの中だけ直せばOK。
VIEW + INSTEAD OF TRIGGER も可能だが、運用複雑度が上がりがち。
年替わり運用の定型手順
- 新年DB作成(
App_2027) - スキーマ・インデックス投入
- GatewayDB の VIEW を切替
- 旧年DBを READ_ONLY 化
- バックアップ頻度調整(当年厚く、過去年薄く)
👉 必ずスクリプト化 する。
ID衝突への対策(重要)
年別DBでは IDENTITY が毎年 1 から始まる問題がある。
安全な選択肢:
(Year, Id)の複合キー- GUID
- 年別ID範囲割当
👉 実務では 複合キー が一番バランス良し。
結論
- SQL Server Express の 10GB 制限は 設計で回避可能
- 最初の一手は 水平分割(年別DB)
- VIEW + GatewayDB でアプリから完全に隠蔽
- 「当年用」と「横断用」を分けるのが安定運用のコツ
おわりに
Express は制限がある分、 設計と運用が整理されているシステムほど強い。
「年別DB + GatewayDB + VIEW」は、 無料版で長く戦うための王道パターンです。
この記事は、SQL Server Express を実運用で使い続ける開発者向けにまとめました。
宣伝
この記事が良いなと思った方はこちらもお試しいただけると幸いです。
KindleなどのアプリをキャプチャーしてPDF化できます。
Screen Capture App
apps.microsoft.com
AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com
Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。あのFilesよりも高速です。
apps.microsoft.com
kanri を日本語化して Tauri アプリを動かすまで(Windows / Yarn / Rust)【更新版】
WindowsでGitのGPG署名を設定してGitHub Verifiedを出すまで(noreply対応)
この記事は、Windows 環境で Git の GPG 署名を設定し、GitHub で Verified 表示を出すまでに実際にハマったポイントと解決手順をまとめたものです。
OSS への Pull Request で GPG 署名必須と言われ、さらに Vigilant mode の警告に悩まされた実体験ベースの記事になります。
この記事の対象読者
- Windows で Git を使っている人
- OSS に PR を出そうとしている人
- GitHub で
Verifiedが出ずに困っている人 gpg failed to sign the dataやNo secret keyで詰まった人- noreply メールを維持したい人
環境
きっかけ
OSS リポジトリに PR を出そうとしたところ、次の条件がありました。
github.com
- Git コミットは GPG 署名必須
- GitHub 上で Verified 表示が必要
とりあえず鍵を作って署名したものの、
No secret key- 署名できたのに GitHub で Verified にならない
- Vigilant mode の警告が消えない
と、順番に地雷を踏みました。
ハマりポイント①: No secret key エラー
git commit -S
で次のエラーが出ました。
gpg: signing failed: No secret key
原因
Git Bash が使っている gpg と、Kleopatra が使っている gpg が別物だったためです。
- Git Bash:
/usr/bin/gpg(MSYS2) - Kleopatra: Gpg4win の
gpg.exe
結果として、Git からは秘密鍵が見えませんでした。
解決①: Git に Gpg4win の gpg.exe を使わせる
git config --global gpg.program "C:\\Program Files\\GnuPG\\bin\\gpg.exe"
これで Git の署名処理は Gpg4win 側の gpg を使用するようになります。
確認:
git config --global --get gpg.program
ハマりポイント②: Verified にならない(Vigilant mode)
署名はできているのに、GitHub では次の警告が表示されました。
The email in this signature doesn’t match the committer email.
原因
- GPG 鍵の UID:
xxx@gmail.com - Git の committer email:
xxx@users.noreply.github.com
署名 UID と committer email が一致していないためです。
解決②: noreply を維持したまま警告を消す
方針:
GPG 鍵に noreply メールを UID として追加する
手順
gpg --edit-key YOUR_KEY_ID
gpg> adduid
入力内容:
- Name: 自分の名前
- Email:
username@users.noreply.github.com - Comment: 空
gpg> save
これで 1つの鍵に複数 UID を持たせられます。
既存コミットを再署名する
git commit --amend --no-edit -S
git push --force-with-lease
それでも Verified にならなかった話
ローカルでは完全に正しく署名されているのに、 GitHub 上では Verified にならないケースがありました。
最終的な解決策
👉 GitHub の GPG key を一度削除して、再インポート
これで GitHub 側の鍵メタデータが更新され、Verified 表示になりました。
※ UID を追加した場合、GitHub 側の再登録が必要になることがあります。
最終状態(理想形)
- GPG 署名あり
- GitHub Verified 表示あり
- noreply メール維持
- Vigilant mode 警告なし
ハマりポイント③: 別のリポジトリで再発する問題
kanri リポジトリでは直ったのに、別のリポジトリで再び同じエラーが出ることがありました。
error: gpg failed to sign the data:
(no gpg output)
原因
- Git Bash / PowerShell / IDE(Cursor / Visual Studio など)を行き来
- gpg-agent が 複数起動
- ソケット(通信口)が衝突
設定は正しいのに、実行環境が壊れているだけという状態でした。
解決③: gpg-agent の完全リセット
Git Bash で以下を実行します。
gpgconf --kill all
rm -f /c/Users/USERNAME/.gnupg/S.gpg-agent*
rm -f /c/Users/USERNAME/.gnupg/S.dirmngr
rm -f /c/Users/USERNAME/.gnupg/S.keyboxd
その後の正しい順序が重要です。
※ 補足(安定しない場合のみ)
Windows 環境では、gpg-agent が複数起動して不安定になることがあります。 その場合のみ、**先に Kleopatra を起動してから Git 操作を行う
これで安定して署名できるようになりました。
再発防止の運用ルール(重要)
git commit --allow-empty -m "gpg warmup"
まとめ(チェックリスト)
- [ ] Git が使う gpg は Gpg4win のものか
- [ ]
user.signingkeyは秘密鍵が存在する Key ID か - [ ] GPG 鍵に noreply UID を追加しているか
- [ ] 既存コミットを再署名したか
- [ ] GitHub 側で鍵を再インポートしたか
- [ ] gpg-agent が多重起動していないか
おわりに
Windows + Git + GPG + GitHub は、 正直かなりハマりやすい組み合わせです。
この記事が、同じところで時間を溶かす人を一人でも減らせたら嬉しいです。
宣伝
この記事が良いなと思った方はこちらもお試しください。
KindleなどのアプリをキャプチャーしてPDF化できます。
Screen Capture App
apps.microsoft.com
AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com
Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。あのFilesよりも高速です。
apps.microsoft.com
購入したKindle本(技術本)をUI Automationでキャプチャし、原寸PDF+OCRにする方法
※ 本記事は 私的利用・自分用整理 を前提とした技術メモです。再配布・公開を目的とするものではありません。
はじめに(なぜやったか)
Kindle は読むには非常に便利ですが、
- 技術書・資料として 後から検索したい
- 複数冊を横断して 参照したい
- ノート・知識ベースとして 蓄積したい
といった用途では、正直つらい場面があります。
コピー制限、検索精度、アプリ依存……。
そこで私は、
Kindleを「読むもの」から「検索できる資料」に変換する
という目的で、以下の仕組みを作りました。
全体構成(完成形)
Kindle アプリ
  ↓ UI Automation(本文領域を特定)
連番PNG(原寸キャプチャ)
  ↓ PDFSharp
原寸PDF(ページサイズ=画像サイズ)
  ↓ Adobe OCR
検索可能PDF
ポイントは 途中で一切劣化させない ことです。
KindleキャプチャをUI Automationで行う理由
なぜ座標指定ではダメか
- DPI変更でズレる
- ウィンドウサイズ変更で壊れる
- 環境依存になりやすい
長期運用や再実行を考えると、非常に不安定です。
UI Automationの利点
- Kindleウィンドウを特定できる
- 本文表示領域を UI要素として取得 できる
- 常に同じ論理領域をキャプチャできる
結果として、
- 毎ページ 完全に同一範囲
- 余白・ツールバー混入なし
という安定した PNG が得られます。
連番PNGで保存する
キャプチャ結果は以下のように保存します。
・・・001.png
・・・002.png
・・・003.png
...
- ゼロ埋め連番
- 1ページ=1ファイル
これだけで 後段のページ順が100%保証 されます。
なぜ「原寸PDF」にこだわるのか
ここが最大のハマりポイントでした。
よくある失敗:
- A4に変換される
- 勝手に縮小される
- DPIが変わる
- OCR精度が落ちる
OCRは 入力画像の品質がすべて です。
そのため、
という状態を必ず守る必要があります。
PDFSharpを使った理由
PDFSharp を選んだ理由はシンプルです。
- PDFページサイズを pt単位で明示指定 できる
- 画像を スケーリングなしで配置 できる
- ページ順をコードで完全制御できる
「自動化」「再現性」「劣化なし」を同時に満たせました。
原寸PDFの基本式
PDFは 1pt = 1/72 inch なので、以下の式になります。
pageWidthPt  = pixelWidth  * 72 / dpi
pageHeightPt = pixelHeight * 72 / dpi
- 画面用途: dpi = 72
- 印刷前提: dpi = 300
この計算でページを作り、画像を等倍配置します。
※PDFSharpの場合そこまで意識しなくても大丈夫でした。
OCRは最後に一度だけ行う(Adobe Acrobatで手動)
OCRは 自動化せず、最後に手動で一度だけ 行いました。
理由はシンプルで、
- OCRの仕上がりを自分の目で確認したい
- 日本語技術書は微妙な誤認識が起きやすい
- 一度きりの作業なので自動化の優先度が低い
からです。
手順としては以下です。
この方法で、
- 見た目はキャプチャしたKindleそのまま
- 中身は検索・コピー可能
というPDFになります。
重要なのは、OCR前に一切の画像加工・再保存を挟まない ことです。
OCR時の設定メモ
- 言語:日本語(必要に応じて英語も追加)
- 出力形式:検索可能なテキスト(画像保持)
これで、
- 見た目は元のKindle
- 中身は検索・コピー可能
という状態になります。
注意点・利用範囲について
本記事の内容は以下を前提としています。
- 私的利用・個人整理目的
- 再配布・共有は行わない
- DRM解除や改変は行っていない
- 表示された画面を記録しているだけ
この点は明確に区別して扱う必要があります。
まとめ
Kindle本を、
- 劣化させず
- 順序を保ち
- OCR精度を最大化し
- 再現可能な形で
扱うには、以下の流れが最も安定しました。
UI Automation Capture
 → 原寸PNG
 → PDFSharp 原寸PDF
 → OCR
「読むためのKindle」から 「検索できる自分専用資料」へ。
同じ悩みを持つ方の参考になれば幸いです。
そもそも技術書はPDF版を買うのが一番です。
宣伝
この記事が良いなと思った方はぜひお試しください。
Screen Capture App
apps.microsoft.com
AWSとAzureそれぞれ100問の問題集です。
Cloud Exam Trainer
apps.microsoft.com
GitHubのContoributionを簡単にシェアできるアプリを作りました。
apps.microsoft.com
Windows11標準のエクスプローラーよりも高速に動くエクスプローラーを作りました。あのFilesよりも高速です。
apps.microsoft.com
